Alla vill ha AI. Nästan alla har en pilot. Förvånansvärt få har något som körs i produktion, med riktiga användare, riktig data och en driftansvarig som kan sova på natten. Den som söker efter en AI-konsult eller en AI agency i dag hittar hundratals som kan bygga en demo. Färre pratar om det som händer efter demon: var modellen ska köras, vem som kommer åt datan, vad det kostar per månad och hur ni förklarar alltihop för en revisor.
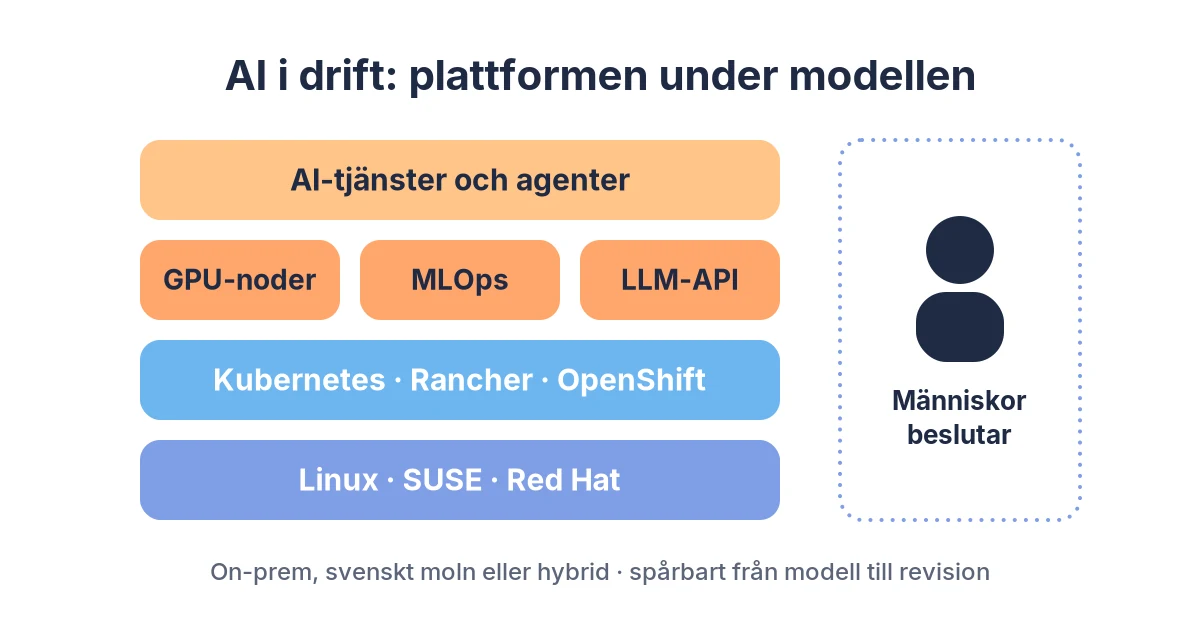
Den här artikeln går igenom vad ett AI-uppdrag faktiskt kräver när det ska ut i drift: egen LLM-drift on-prem, GPU på Kubernetes, MLOps på Kubernetes och AI-agenter som hjälper till utan att ta över. Vi går också igenom vad EU:s AI-förordning kräver och när kraven börjar gälla. Vår vinkel är enkel: vi bygger plattformen som AI:n kör på, säkert och spårbart. AI ger människor tid, och människor fattar besluten.
Har du frågor om ämnet? Tveka inte att höra av dig till oss!
Har du frågor om ämnet? Tveka inte att höra av dig till oss!
Två sorters AI-konsulter
Marknaden för AI-konsulter i Sverige delar sig grovt i två läger.
- Användningsfallskonsulterna hjälper er att hitta var AI gör nytta: i kundtjänst, ekonomi, dokumenthantering eller försäljning. De är bra på processer, promptar och integrationer, och de använder ofta publika AI-tjänster.
- Plattformskonsulterna bygger och driftar det som allt annat står på: kluster, GPU:er, nätverk, lagring, säkerhet, övervakning och uppgraderingar. De ser till att modellen fortfarande svarar om sex månader, efter tre säkerhetspatchar och en ny modellversion.
Båda behövs. Problemet är att många AI-uppdrag startar i det första lägret och kör fast när de når det andra. Piloten byggdes mot ett publikt API med testdata. Sedan säger informationssäkerhetsansvarig nej till att skicka riktiga kundärenden till ett amerikanskt moln, och projektet står still.
Vi hör hemma i det andra lägret. Vi är Sveriges go-to Kubernetes-specialister, och AI i produktion är i grunden en plattformsfråga: samma containrar, schemaläggning och säkerhet som vanlig mjukvara, fast med dyrare hårdvara och hungrigare arbetslaster. Läs mer om vår AI-tjänst.
Varför AI-piloter fastnar
Det är sällan modellen som är problemet. Oftast är det någon av de här frågorna som saknar svar:
- Data: får den här datan lämna organisationen? Landet? EU?
- Drift: vem äger tjänsten när den har gått i produktion? Vem larmas när den slutar svara?
- Kostnad: vad händer med fakturan när 500 medarbetare börjar använda den i stället för fem?
- Spårbarhet: vilken modellversion svarade vad, till vem, och med vilken data?
- Ansvar: vem fattar beslutet när AI:n föreslår något?
Ett AI-uppdrag som inte besvarar de frågorna tidigt blir en dyr prototyp. Ett som besvarar dem blir en tjänst.
On-prem LLM: när datan inte får lämna huset
För många organisationer är det enklaste svaret på datafrågan att köra språkmodellen själv: on-prem i det egna datacentret eller hos en svensk molnleverantör. Det gäller särskilt offentlig sektor, finans, vård, försvarsnära verksamhet och företag med känslig produktdata.
En on-prem LLM är inte en modellfil på en server. En tjänst som håller i produktion behöver:
- Ett internt API som era applikationer och utvecklarverktyg kan anropa, gärna kompatibelt med de API-format verktygen redan förstår.
- Autentisering och behörigheter, så att rätt team når rätt modell, kopplat till er befintliga identitetshantering.
- Loggning och spårbarhet av vem som anropade vad och när, med en tydlig policy för vad som får sparas av själva promptinnehållet.
- Kapacitetsstyrning i form av köer, kvoter och prioritering, så att en batchkörning inte svälter ut den interaktiva tjänsten.
- Livscykel: nya modellversioner, säkerhetsuppdateringar av hela stacken och en väg tillbaka när den nya versionen beter sig konstigt.
Öppna modeller går att köra lokalt, och utvecklingen går fort. Vilken modell som är bäst ändras ungefär varannan vecka. Därför ska plattformen göra det lätt att byta modell. Bygg inte in er i en enda.
För de mest skyddsvärda miljöerna kan plattformen utformas för isolerad (airgappad) drift, med speglade images, modellvikter och register inne i den isolerade miljön. Kubernetes-distributioner som RKE2 och OpenShift stöder installation utan internetanslutning. Det kräver disciplin i leveranskedjan, och det är exakt samma disciplin som reglerade Kubernetes-miljöer redan kräver.
GPU på Kubernetes: dyr hårdvara ska inte stå still
En GPU-server kostar lika mycket som en mindre bil och drar ström som ett litet kvarter. Står den still halva dagen eftersom team A har reserverat den "för säkerhets skull" har ni ett ekonomiskt problem som ser ut som ett tekniskt.
GPU på Kubernetes löser det med samma verktyg som för all annan kapacitet:
- Schemaläggning: arbetslaster begär GPU-resurser, och Kubernetes placerar dem på noder som har dem.
- Delning: beroende på hårdvara kan en GPU delas mellan flera arbetslaster, till exempel med NVIDIA:s Multi-Instance GPU (MIG) eller time-slicing. Små inferenstjänster behöver sällan ett helt kort.
- Köer och kvoter: varje team får en garanterad andel och kan låna ledig kapacitet när den finns.
- Drivrutiner som kod: en operator, till exempel NVIDIA GPU Operator, kan hantera drivrutiner, container-runtime och övervakning av GPU:erna, så att noderna inte blir unika snöflingor som bara en person vågar röra.
- Övervakning: utnyttjandegrad, minne, temperatur och kostnad per team, så att investeringen går att följa upp.
Det fungerar på de plattformar ni redan kan: RKE2 och Rancher, OpenShift eller managed Kubernetes. Har ni inte valt plattform ännu finns vår jämförelse SUSE Rancher vs OpenShift. Grunden är densamma som för allt annat vi bygger på Kubernetes: härdade kluster, GitOps och policyer som går att visa upp.
MLOps på Kubernetes: från notebook till revision
En modell som bara körs i en notebook på en laptop är ett experiment. MLOps är det som gör den till en tjänst, och på Kubernetes kan ni använda samma principer som för vanlig mjukvara:
- Versionera allt. Kod, data, modellvikter och konfiguration. Ni ska kunna svara på frågan "vilken modell körde i produktion den 3 mars, och vad tränades den på?".
- Bygg och signera. Modeller och containrar byggs i en pipeline, skannas och signeras, precis som i en vanlig DevSecOps-kedja. En SBOM för modellens beroenden är lika relevant som för vilken annan programvara som helst.
- Rulla ut med GitOps. En ny modellversion är en ändring i Git, granskad och godkänd av en människa. Den rullas ut stegvis, och går något snett backar ni med en revert.
- Övervaka både plattform och modell. Svarstider och GPU-last är plattformens hälsa. Kvalitet, drift i indata och oväntade svar är modellens.
- Spara bevisen. Pipelinehistorik, godkännanden och loggar är samma underlag som en revisor, en kund eller en tillsynsmyndighet kan be om.
Verktygen är många och skiftar över tid. En plattform kan till exempel bygga på öppna verktyg som MLflow för experiment och modellregister, och KServe eller vLLM för modellservering. Det viktiga är inte vilka logotyper som finns på arkitekturbilden. Det viktiga är att kedjan är reproducerbar och spårbar.
AI-agenter: de föreslår, människor beslutar
AI-agenter, alltså AI som inte bara svarar på frågor utan också utför uppgifter i flera steg, är det som rör sig snabbast just nu. Många söker efter "agent consulting" och undrar var agenterna gör nytta på riktigt. I drift och DevSecOps finns gott om tråkigt, repetitivt arbete som passar dem:
- sammanfatta sårbarhetsrapporter och föreslå vilka CVE:er som faktiskt berör er,
- granska pull requests mot era säkerhets- och stilregler,
- skriva första utkastet till en incidentrapport eller ett ändringsärende,
- hålla ordning på SBOM:er och beroenden,
- korrelera larm och föreslå trolig orsak.
Vår regel är enkel: agenten föreslår, en människa beslutar. Agenter får läsa och föreslå, men inte trycka på knappen i produktion. Varje förslag loggas tillsammans med vem som godkände det. Då kan en ingenjör hantera fler ärenden på kortare tid, utan att någon förlorar kontrollen över vad som faktiskt händer.
Det här är också vår syn på AI i stort. AI ska ta bort det tråkiga och ge ingenjörer mer tid till det som kräver omdöme. AI ersätter inte människor hos oss, och vi bygger inte system som gör det hos er heller.
AI-förordningen: vad gäller och när?
EU:s AI-förordning, förordning (EU) 2024/1689 (AI Act), trädde i kraft den 1 augusti 2024 och börjar gälla stegvis. Datumen nedan gäller enligt artikel 113, i lydelse efter ändringsförordningen (EU) 2026/1744 (Digital Omnibus on AI), som publicerades i EU:s officiella tidning den 24 juli 2026:
- 2 februari 2025: förbuden mot vissa AI-tillämpningar (artikel 5) började gälla.
- 2 augusti 2025: reglerna för AI-modeller för allmänna ändamål (kapitel V) började gälla.
- 2 augusti 2026: förordningens allmänna tillämpningsdatum.
- 2 december 2027: kraven på högrisk-AI-system enligt bilaga III, till exempel vissa system inom anställning, utbildning och offentliga tjänster.
- 2 augusti 2028: kraven på högrisk-AI-system som ingår i produkter enligt bilaga I.
För högrisksystem ställer förordningen bland annat krav på riskhantering, loggning, dokumentation och mänsklig tillsyn (artikel 14). En plattform som från början loggar vem som använde vilken modell, med vilken version och vilket godkännande, gör de kraven betydligt lättare att uppfylla. Om just ert system är högrisk avgörs av vad det används till, inte av vilken modell det bygger på. Den bedömningen gör ni med juridiskt stöd.
Glöm inte de regler som redan gäller. En AI-plattform är ett IT-system bland andra, och för verksamheter som omfattas av cybersäkerhetslagen gäller kraven på riskhantering, åtkomstkontroll och incidenthantering även för GPU-klustret. Bygger ni produkter med AI-komponenter kan dessutom EU:s cyberresiliensförordning gälla, med en rapporteringsplikt som redan har börjat tillämpas. Mer om det finns i vår artikel om CRA-rapportering och på vår compliance-sida.
Så väljer du AI-konsult för ett AI-uppdrag
Fem frågor att ställa innan ni skriver på:
- Var ska det köras om två år? Ett svar som bara handlar om piloten är en varningsflagga.
- Vem driftar det? Konsulten, ni själva eller någon annan? Hur ser överlämningen ut?
- Hur byter vi modell? Om svaret är "det gör vi inte" är ni inlåsta.
- Hur visar vi en revisor vad som hänt? Be om att få se loggar, godkännanden och versionshistorik.
- Var fattas besluten? En bra AI-leverans har tydliga punkter där en människa godkänner. Det är en kvalitetsstämpel, inte en brist.
Ibland är det ärliga rådet att inte bygga eget. Om ni har en avgränsad uppgift, ingen känslig data och få användare kan en publik AI-tjänst med rätt avtal vara helt rätt. Därför börjar vi med strategi och rådgivning: användningsfall, data, krav och kalkyl. Hårdvaran kommer sedan.
Sammanfattning
- De flesta AI-piloter fastnar på plattformen, inte på modellen: data, drift, kostnad och spårbarhet.
- On-prem LLM eller ett svenskt moln löser datafrågan, men kräver API, behörigheter, loggning och livscykel för att hålla i produktion.
- GPU på Kubernetes gör dyr hårdvara delbar och mätbar, med köer, kvoter och drivrutiner som kod.
- MLOps på Kubernetes gör modeller lika reproducerbara och spårbara som annan mjukvara.
- AI-agenter gör grovjobbet. Människor beslutar.
- AI-förordningens krav på högrisksystem gäller från 2 december 2027 respektive 2 augusti 2028. Spårbarhet byggd i plattformen från start gör dem lättare att uppfylla.
Vanliga frågor
Vad gör en AI-konsult?
Det beror på sorten. Vissa hjälper er att hitta och bygga användningsfall. Andra, som vi, bygger och driftar plattformen som AI:n körs på: kluster, GPU:er, MLOps, säkerhet och drift. Många uppdrag behöver båda.
Kan vi köra en LLM on-prem utan att tumma på kvaliteten?
För många användningsfall, ja. Öppna modeller har blivit mycket bra, och de går att köra på egen hårdvara eller hos en svensk molnleverantör. Det kräver GPU-kapacitet i rätt storlek och en plattform som gör det lätt att byta till bättre modeller när de dyker upp.
Behöver vi Kubernetes för AI?
Inte alltid. En enda modell på en enda server kan vara helt rätt. När flera team, flera modeller och dyr GPU-kapacitet ska samsas ger Kubernetes er schemaläggning, delning, självläkning och ett gemensamt sätt att drifta.
Vad är MLOps på Kubernetes?
Att träna, versionera, rulla ut och övervaka modeller med samma metoder som för mjukvara: pipelines, GitOps, signering, övervakning och spårbarhet, på en Kubernetes-plattform.
Ersätter AI-agenter driftpersonal?
Nej. Agenter är bra på att sammanfatta, sortera och föreslå. Beslut om vad som rullas ut, rapporteras eller stängs av ska fattas av människor, och det är så vi bygger det.
När börjar AI-förordningens högriskkrav gälla?
Enligt förordning (EU) 2024/1689, ändrad genom (EU) 2026/1744, gäller kraven från den 2 december 2027 för högrisksystem enligt bilaga III och från den 2 augusti 2028 för högrisksystem i produkter enligt bilaga I. Förbuden och reglerna för AI-modeller för allmänna ändamål gäller redan.
Vill du ge er AI ett riktigt hem?
Vi hjälper till med AI-strategi, AI-plattformar på Kubernetes, GPU-kluster, MLOps, egen LLM-drift on-prem eller i svenskt moln, och AI-agenter i DevSecOps och drift. Berätta om er pilot, era data och era krav.
Läs mer på:
- AI-plattformar och AI-rådgivning
- Kubernetes
- DevOps och DevSecOps
- Compliance: NIS2, CRA och AI-förordningen
- Kontakta oss
Källor
Kontrollerade 2026-10-11.
- Europaparlamentets och rådets förordning (EU) 2024/1689 av den 13 juni 2024 (AI-förordningen), artiklarna 5, 14 och 113, kapitel V och bilagorna I och III. eur-lex.europa.eu/eli/reg/2024/1689/oj
- Europaparlamentets och rådets förordning (EU) 2026/1744 av den 8 juli 2026 (Digital Omnibus on AI), EUT L 2026/1744, 24.7.2026, skäl 40 och ändringen av artikel 113. eur-lex.europa.eu
- Förordning (EU) 2024/2847 (cyberresiliensförordningen), artiklarna 14 och 71. eur-lex.europa.eu/eli/reg/2024/2847/oj
- Cybersäkerhetslag (2025:1506), 2 kap. 3 §. riksdagen.se